传统反欺诈系统擅长寻找异常交易:陌生收款人、异常金额、非常用设备、短时间内连续转账。可在授权推送支付诈骗中,真正困难的地方往往不是账户被盗,而是客户本人在骗子诱导下完成了验证,并确信自己正在做正确的事。
这意味着,系统面对的不是一笔单纯的异常交易,而是一个已经被操纵的决定。
10 月 15 日,英国金融行业组织 UK Finance 发布文章,提出 AI 防诈正在从付款时点向更早阶段移动:诈骗者可能已连续数周建立信任,而传统系统直到资金进入支付通道才开始判断,留给干预的时间只有几秒。其 2026 年度欺诈报告显示,2025 年英国授权推送支付(APP)诈骗损失增长 19%,达到 5.764 亿英镑,案件数增至 248,070 起。
近期 Google Cloud 的企业 AI 发布再次提到 Starling Bank 的 Scam Intelligence。Starling 的公开资料显示,客户可以上传网络商城商品、卖家消息或可疑对话截图,由 AI 分析常见诈骗迹象并给出针对性提醒;后续版本覆盖浪漫、投资、养老金和深度伪造等十余类诈骗。Starling 称,这项功能使客户取消可疑商城付款的比例提高了 300%。
这个数字来自银行自身披露,公开材料没有给出原始取消率、使用人数、样本选择、误报与漏报、最终诈骗损失变化或独立审计。因此,它不能证明 AI 已经普遍减少了 300% 的诈骗损失,也不能直接作为其他企业的收益基线。
但它提供了一个比“识别准确率提高多少”更有价值的经营信号:面向客户的风险 AI,真正需要交付的不是一个风险标签,而是一次有效的决定干预。
发现风险与阻止损失之间,还有一段客户旅程
模型判断某张截图“高度可疑”,并不等于客户会停止付款。客户可能已经投入感情、时间或资金,也可能正在被对方制造的紧迫感控制。一个笼统的弹窗——“本交易可能存在风险,是否继续?”——很容易被当作例行提示直接跳过。
从检测到结果,至少存在五个环节:
如果系统只完成第一步,企业得到的是更先进的告警器,而不是更好的客户保护能力。
英国金融行为监管局(FCA)的 Consumer Duty 规则要求金融机构避免可预见伤害,并在客户旅程的关键位置设置“适当摩擦”,让客户有充分机会理解风险和评估选项。同时,规则也要求避免不合理障碍。这一边界非常重要:好的防诈体验不是把所有支付都变慢,而是在高风险、仍可干预的时刻增加足够且有针对性的思考成本。
- 看见信号:识别价格异常、身份矛盾、催促转账、转移沟通渠道等线索;
- 解释风险:说明哪些具体事实值得怀疑,而不是只给出一个分数;
- 打断惯性:在客户仍可撤回时创造恰当停顿;
- 提供下一步:让客户能够核验、延迟、联系专业人员或取消付款;
- 确认结果:记录客户是否改变决定,以及之后是否仍发生损失。
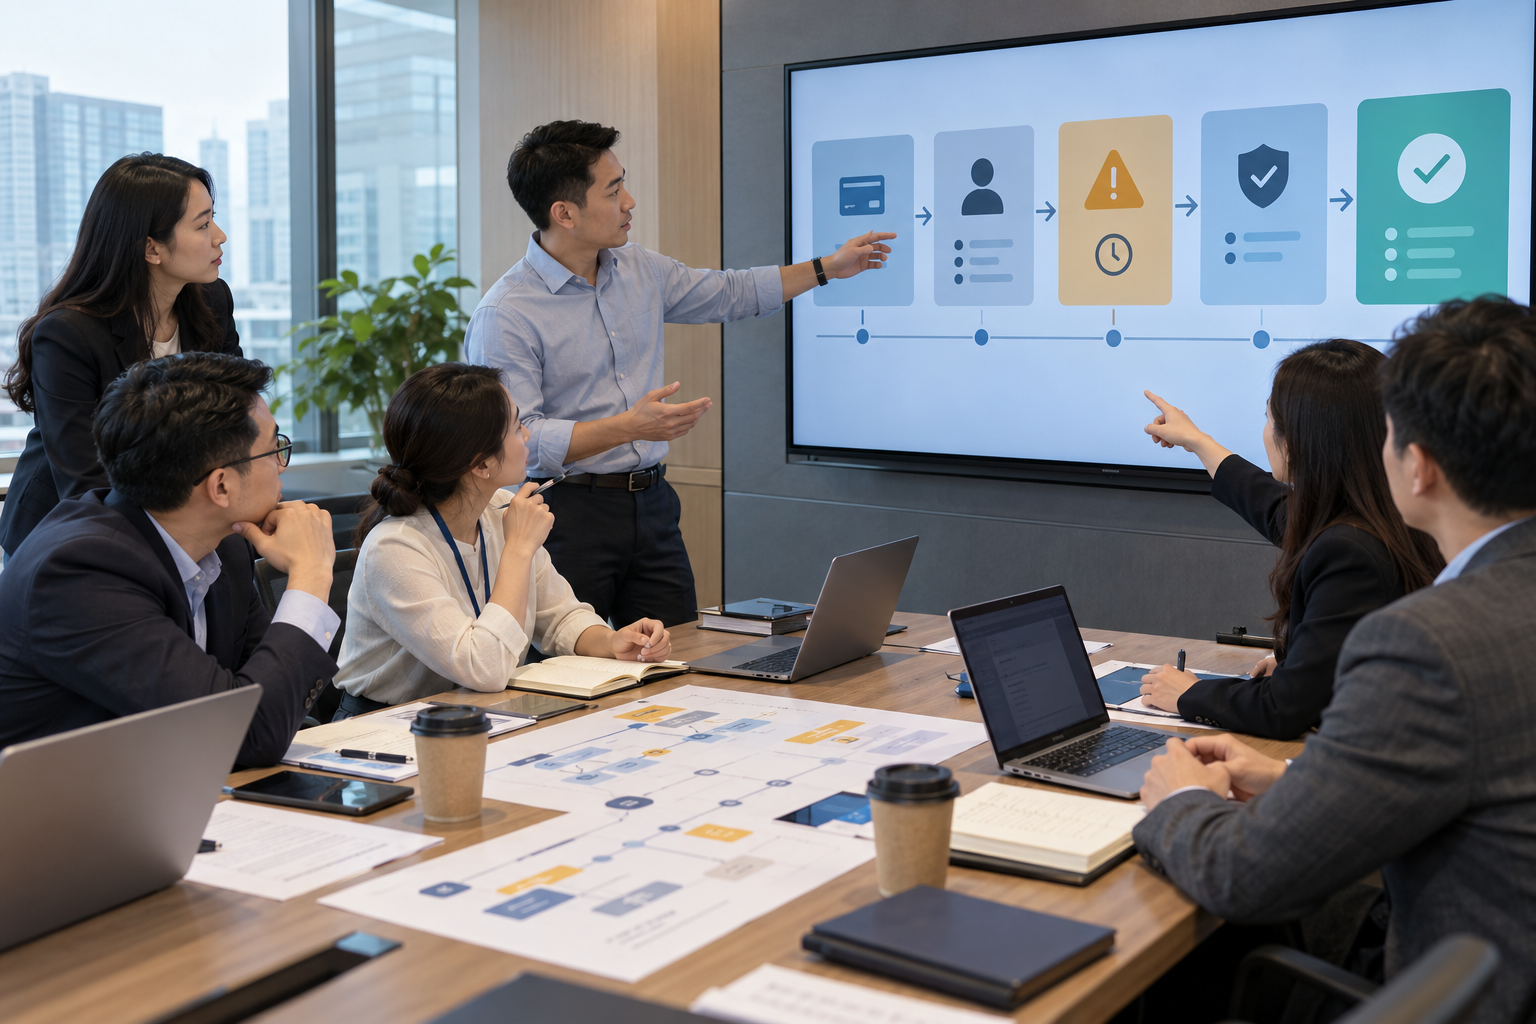
“适当摩擦”应随证据变化,而不是所有人看到同一条警告
很多企业把风险控制理解为增加一个确认框。统一警告容易部署,却会迅速产生提示疲劳。客户反复看到相同文案,最终学会的不是识别诈骗,而是更快点击“继续”。
更有效的做法,是把干预强度与证据、后果和可撤回性绑定:
这里的重点不是让生成式 AI 自由决定是否冻结客户资金。AI 更适合理解截图、对话和场景,提取风险线索,并生成针对当前情境的解释;交易阻断、延迟时间、复核条件和升级权限应由明确规则与授权流程控制。
Starling 自己的帮助资料也明确说明,Scam Intelligence 不能保证发现所有诈骗,真实付款也可能因为具有类似特征而被标记,客户仍可继续付款或寻求人工帮助。这种产品边界比一句“AI 能识别诈骗”更接近企业应有的责任表达。
- 风险状态:客户体验:企业动作
- 证据较弱、后果较低:提供简洁提醒和自主核验入口:记录信号,不阻断正常操作
- 多项信号一致:展示与本次场景直接相关的疑点,要求客户逐项确认:延迟执行并保留干预证据
- 高金额或典型操纵迹象:建议暂停,提供可信核验路径:转交专业团队或强化验证
- 证据高度充分且损失不可逆:明确阻止或暂缓交易:由授权人员复核并记录理由
验收指标要从模型准确率走到客户结果
防诈模型当然需要衡量准确率,但单独优化准确率可能产生错误方向:系统可以通过频繁发出宽泛警告提高覆盖率,却让大量正常客户受到干扰;也可以只拦截最明显的案例,保持漂亮的精确率,却错过高损失的新型骗局。
企业至少应同时观察四层指标:
“取消可疑付款比例提高”比点击告警更接近真实结果,但仍不是终点。取消一笔付款后,客户可能在另一个账户、渠道或时间重新支付;一次误报也可能让客户错过真实交易。企业需要把干预后的结果接回风险系统,观察至少一段合理时间,而不是在客户按下取消键时就宣布成功。
还应按诈骗类型、金额、客户特征和干预方式分组。对熟悉数字金融的客户有效的提示,不一定能帮助处于压力、低数字素养或情感操纵中的人。FCA 明确要求机构考虑客户脆弱性,并通过测试确认信息是否真的被理解;同一段合规文案不等于同样的保护效果。
- 识别质量:在已确认诈骗与正常交易中,系统分别识别了多少,哪些新手法持续漏过;
- 理解质量:客户是否看懂了具体风险,能否复述关键疑点,而不是只记住“银行不建议”;
- 行为结果:客户是否暂停、核验、取消或转人工,之后是否通过其他路径继续付款;
- 最终损失:诈骗发生率、损失金额、追回与赔付、正常交易受阻以及人工服务成本。
风险 AI 需要一份“干预记录”,而不只是模型日志
为了让运营、合规、客服和模型团队能够共同复盘,企业可以为每次高风险干预保留一份结构化记录:
这份记录的价值在于,它把“模型说可疑”变成一条可审计的责任链。出现争议时,企业可以判断问题究竟来自证据不足、解释无效、介入太晚、权限错误,还是客户在得到充分信息后仍选择继续。
它也能避免一个常见误区:把客户最终决定全部归因于 AI。诈骗防护是模型、产品设计、支付规则、专业人员与客户共同作用的结果。企业既不能因为客户点击继续就自动免除自身责任,也不应让 AI 的建议被误解为对交易真假的保证。
- 当时出现了哪些可验证信号,信息来自交易、设备、截图还是客户陈述;
- AI 给出了哪些判断,哪些是事实、推断和未知;
- 系统在什么时点介入,当时付款是否仍可撤回;
- 客户看到了什么解释,采取了什么动作;
- 是否发生人工升级,谁批准了阻断、放行或例外处理;
- 后续是否确认诈骗、发生损失、收到投诉或发现误报;
- 本次结果应如何更新规则、提示或人工处置流程。
最合适的起点,是一段可回放的付款前旅程
企业不必先建设覆盖所有诈骗类型的通用 Agent。更稳妥的起点,是选取一种损失明确、历史案例充足、在付款前存在可干预窗口的场景,例如网络商城付款或首次向陌生收款人转账。
先用历史案例回放,检查系统能否在当时可获得的信息范围内指出具体证据,不能让模型读取事后调查结论。随后进行受控试点,对比原有通用警告与情境化干预,重点观察:
达到扩大条件后,再逐步接入更多信息和诈骗类型。每次扩展都应重新评估数据用途、误报后果、客户脆弱性和人工承接能力,而不是因为模型能够读取更多材料,就默认企业应该收集更多材料。
UK Finance 的最新信号说明,诈骗对抗正在从“支付发生时拦截异常”转向“在客户形成决定的过程中发现操纵”。这不只适用于银行。保险理赔、电商交易、企业采购、账户变更和高风险合同确认,都存在类似问题:系统即使判断正确,也必须在正确时点,以客户能理解的方式,提供一个可执行的安全出口。
企业级 AI 的专业性,不体现在它能发出多少告警,而体现在它能否把风险证据变成一次及时、克制、可解释的干预:既让客户有机会重新思考,也让企业能够证明自己为什么介入、介入是否有效,以及误判发生后如何纠正。
- 干预是否发生在资金不可逆之前;
- 客户是否真正理解风险,而不只是完成确认步骤;
- 正常交易被延迟或放弃的比例是否可接受;
- 取消后是否出现换渠道付款;
- 人工团队能否接住高风险升级,且拥有完整上下文;
- 新型诈骗出现后,证据、规则和话术多久能够更新。
